В генеративные ответы попадают не «хорошие тексты» в целом, а фрагменты, из которых можно вырезать короткий факт или самодостаточный блок. Практический вывод простой: страницу стоит проектировать как набор готовых ответов, а не как связный рассказ.
Какие семь приёмов повышают шанс на цитирование?
Семь приёмов чаще всего срабатывают в Алисе AI, Яндекс Нейро и ChatGPT. Это ответ в начале, плотность фактов, ранняя позиция цитируемого блока, заголовки-вопросы, таблицы, списки и подтверждение авторства. Ниже – каждый с пояснением и ожидаемым эффектом.
Приём | Зачем | Эффект |
Answer-First | Ответ в первых 2–5 предложениях, без вступления | Блок цитируется целиком, без искажений |
Плотность фактов | Вместо «повысили эффективность» – «с 3 500 до 1 200 ₽ за операцию» | По данным аналитики добавление статистики даёт до +40% к ранжированию |
Верх страницы | Основной вес блоков в начале текста | 44,2% цитат LLM приходится на первые 30% текста (Grows Memo, февраль 2026) |
Заголовки-вопросы | Совпадение с подтемами query fan-out | Страница отвечает на несколько смежных запросов |
Таблицы | Сравнения и характеристики в сопоставимом виде | Данные переносятся в ответ без пересказа |
Списки | Маркированные и нумерованные перечни | Пункты цитируются по отдельности |
Авторство и даты | Блок об авторе, дата обновления, ссылка на своё исследование | Повышается доверие и вес блока в Нулевой выдаче |
И цифры выше объясняют приоритет. Длинный «хвост» статьи работает слабее, чем проработанное начало. Если ключевой вывод стоит на пятом экране, велика вероятность, что до него не дотянутся.
Как выглядит перестройка страницы: до и после
До оптимизации была типичная структура коммерческого лендинга. Заголовок H1 «Услуги CRM», затем три абзаца сплошного текста без структуры. Первый абзац – «компании растут, когда они получают правильный инструмент». Второй – история про ООО, которое внедрило CRM и увеличило продажи. Третий – цены и условия. Зато цитировать здесь нечего. Нейросеть не находит готового ответа: нет чёткого тезиса и нет таблицы, а каждый абзац пришлось бы переписывать.
После оптимизации та же информация выглядит иначе. H1 остался, но под ним сразу H2 «Когда компании вообще нужна CRM». Первый абзац – прямой ответ из 48 слов: «CRM нужна, когда количество клиентов превышает 50 и их не удаётся отслеживать в таблице Excel. Признаки такие: потеря лидов, срывы сроков звонков, хаос в переписках». Затем H2 «Пять критериев выбора CRM» с нумерованным списком, где интеграция с вашей телефонией стоит на первом месте, дальше – автоматизация рутины и отчёты по воронке продаж. Дальше идёт таблица сравнения трёх популярных CRM, а затем H2 «FAQ по внедрению CRM» с тремя вопросами в H3. Каждый раздел – самостоятельный ответ, каждый можно вырезать и процитировать.
Результат: страница появилась в ответах Алисы по запросам «когда нужна CRM», «как выбрать CRM», «CRM для малого бизнеса». Каждый раздел был процитирован отдельно в разных ответах на протяжении двух месяцев.
Почему контент под табами и аккордеонами часто не видят?
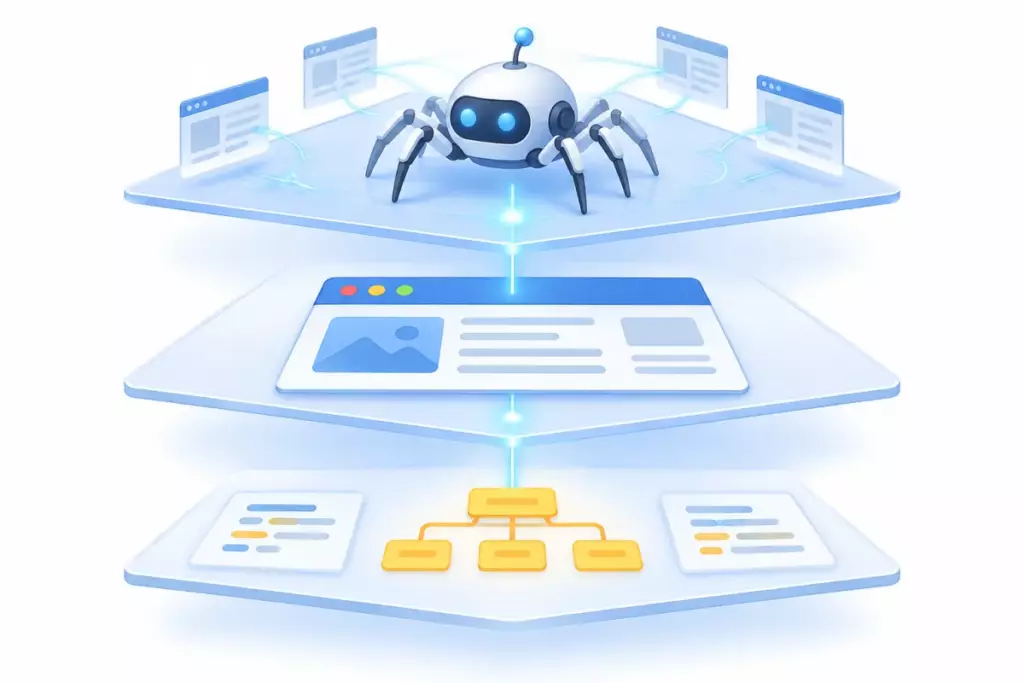
Скрытые блоки – типичная причина, по которой страница выглядит полной, но в ответы не попадает. Большинство краулеров читают исходный HTML, а не состояние элементов после клика. Практический вывод простой. Важные формулировки, таблицы и списки должны быть в разметке страницы, а скрытие допустимо только для второстепенных деталей. Это же касается текста, загружаемого скриптом уже после отрисовки.
Отдельная роль – разметка Schema.org. Она не заменяет текст, но помогает системе связать сущности на странице: автор, организация, даты, тип публикации. Для E-E-A-T и Нулевой выдачи полезна корректная семантика, а не декор.
Внешние площадки – Habr, vc.ru, Яндекс.Дзен, СМИ – попадают в ответы по тем же правилам, что и сайты компаний: те же заголовки-вопросы, та же плотность фактов, та же авторская подпись. Формат площадки меняет охват аудитории, но не механику отбора источников.